Segunda parte de un tríptico. La primera, La forma de lo probable, plantea el argumento; la tercera, La forma de lo probable, en fórmulas, lo desarrolla con todo su aparato matemático. Esta versión cuenta lo mismo con esquemas y sin una sola ecuación.
Para entender qué hace una inteligencia artificial cuando responde no hace falta saber matemática, sino seguir un recorrido: de una pequeña cuenta que vota a una pregunta que se convierte en números y vuelve convertida en palabras. Este texto propone ese recorrido.
Alguien escribe en una ventana de chat: “¿Cómo va a estar el cielo hoy?”. A los pocos segundos aparece una respuesta fluida, bien redactada, con un tono razonable. Es difícil no imaginar a alguien del otro lado, o al menos a una máquina que miró por la ventana. No ocurrió ninguna de las dos cosas. Lo que ocurrió es más modesto y, a la vez, más extraño.
La pregunta que ordena este texto es simple: ¿qué pasó entre que se apretó la tecla de enviar y apareció la respuesta? Para contestarla conviene empezar por la pieza más pequeña.
Una cuenta que vota
La unidad básica de una inteligencia artificial se llama, por razones históricas, neurona artificial. El nombre engaña. No se parece a una célula del cerebro; se parece más a un pequeño comité que vota.
Conviene imaginar un comité de tres miembros. Cada uno trae una opinión, pero no todas las opiniones pesan lo mismo: la voz de uno vale mucho, la de otro vale poco y la de un tercero, cuando habla, resta en lugar de sumar. El comité junta los votos, cada uno con su peso, y mira si el total alcanza un umbral. Si lo alcanza, se pronuncia; si no, se queda callado.
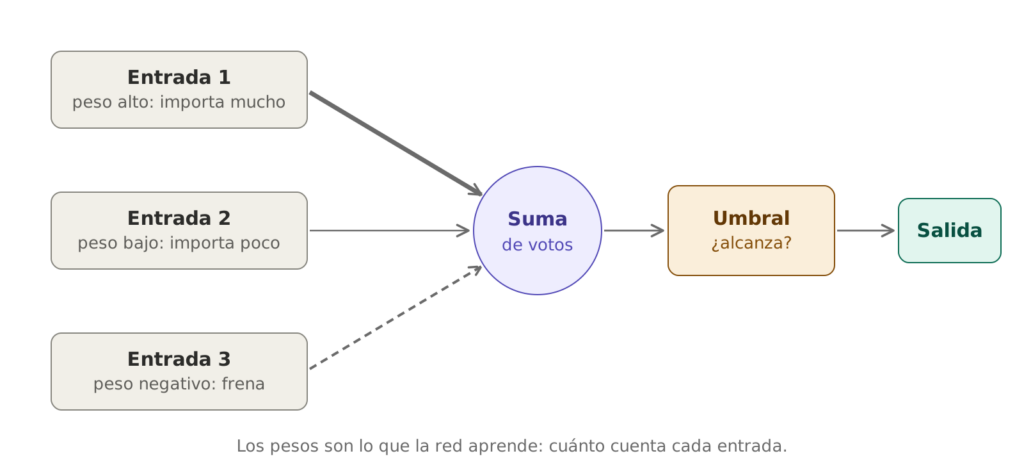
Una neurona artificial: tres entradas con pesos distintos se suman y, si alcanzan un umbral, producen una salidaEso es todo. Las entradas son números, los pesos son números y la salida es un número. Lo único interesante es de dónde salen los pesos, porque nadie los escribe a mano: se aprenden. Más adelante se verá cómo.
Muchas cuentas en fila
Una sola neurona es casi inútil. La potencia aparece cuando se conectan muchas, de modo que lo que dice una se convierte en entrada de otras. Al conectarlas se forma una red, y ese es el sentido literal de la expresión “red neuronal”: puntos unidos por líneas.
La forma más común de organizarlas es en capas. La primera recibe los datos tal como vienen. Cada capa siguiente trabaja sobre lo que entregó la anterior, y la última da el resultado.
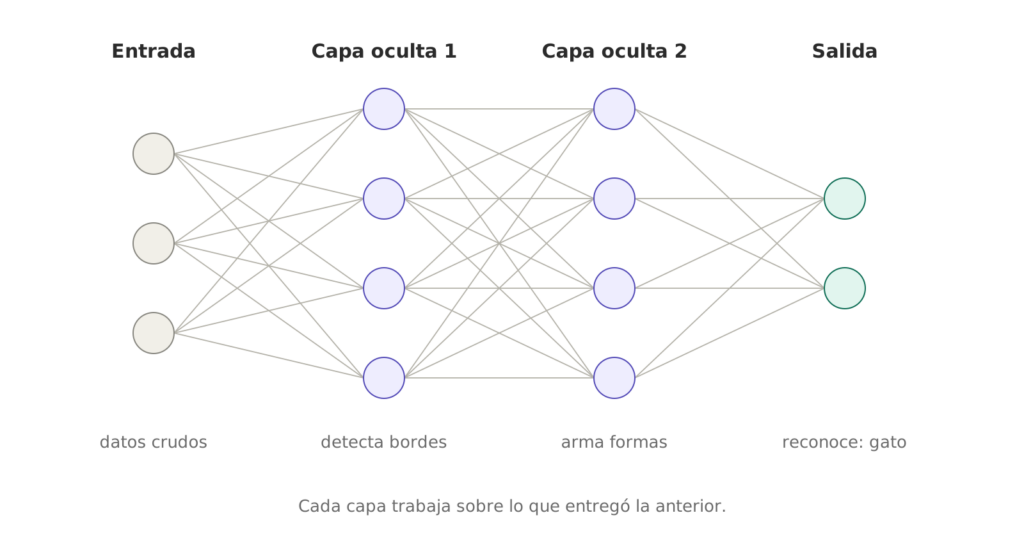
Una red en capas: la entrada pasa por dos capas ocultas hasta la salida, y cada capa detecta algo más elaboradoLo notable es que nadie le indica a la red qué debe hacer cada capa. En una red que mira fotos, las primeras capas terminan detectando bordes, las del medio arman formas y las últimas reconocen objetos. Esa división del trabajo aparece sola durante el aprendizaje, porque construir lo complejo a partir de lo simple resulta la manera más económica de resolver el problema. Cuando se habla de aprendizaje “profundo”, la palabra no esconde ningún misterio: quiere decir, simplemente, muchas capas.
Dónde está lo aprendido
Si se abriera una de estas redes por dentro no se encontrarían palabras, reglas ni datos guardados en ningún lado. Se encontrarían números: los pesos de todas las conexiones. Una imagen útil es la de una consola de sonido con miles de millones de perillas, cada una en una posición precisa. Los modelos más grandes tienen cientos de miles de millones.
Lo incómodo es que ninguna perilla, mirada sola, significa algo. No hay una perilla para “París” ni otra para “ironía”. Lo que la red sabe está repartido en la combinación de todas, y cada perilla participa a la vez en muchas cosas distintas. Por eso es tan difícil explicar por qué una inteligencia artificial dijo lo que dijo: la respuesta no está escrita en un lugar, sino distribuida en todo el aparato.
El viaje de una pregunta
Con esas piezas se puede seguir el recorrido de la pregunta del principio.
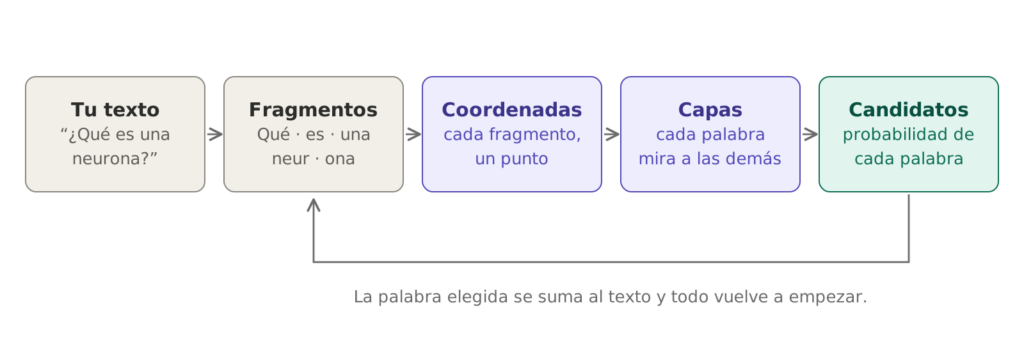
El viaje de un prompt: el texto se parte en fragmentos, cada fragmento se vuelve un punto, las capas agregan contexto y al final aparecen candidatos con su probabilidadPrimero, el texto se corta. La red no lee letras ni palabras enteras. Un programa previo parte el texto en fragmentos frecuentes: a veces una palabra completa, a veces un pedazo, como “neur” y “ona”. A cada fragmento le corresponde un número de un diccionario fijo.
Segundo, cada fragmento se vuelve un lugar. Cada número se traduce en una posición dentro de un espacio gigantesco, una especie de mapa de significados con miles de direcciones. En ese mapa, los fragmentos que se usan de manera parecida quedan cerca: “perro” cerca de “gato”, “lunes” cerca de “martes”. También se anota el orden en que venían, porque no es lo mismo “el perro mordió al hombre” que lo contrario.
Tercero, cada palabra mira a las demás. Aquí está el corazón de los modelos actuales, un mecanismo llamado atención. En cada capa, cada fragmento “mira” a los anteriores y toma de ellos lo que le sirve. La palabra “banco” significa una cosa si antes apareció “plaza” y otra si apareció “préstamo”; la atención es lo que le permite a la red notar esa diferencia. Capa tras capa, cada fragmento se va cargando de contexto.
Cuarto, aparecen candidatos. Al final del recorrido, la red no produce una respuesta: produce una lista de todas las palabras posibles, cada una con su probabilidad de ser la siguiente.
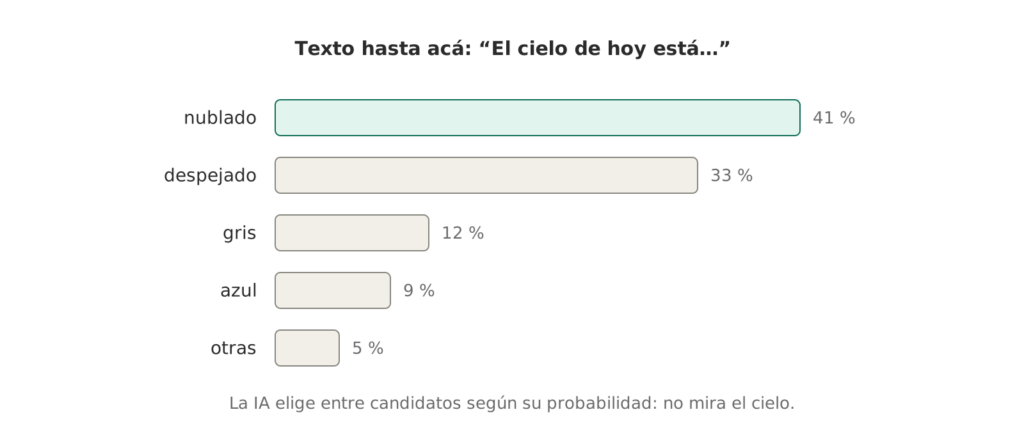
Candidatos para continuar “El cielo de hoy está…”: nublado 41 %, despejado 33 %, gris 12 %, azul 9 %, otras 5 %De esa lista se elige una. No siempre la más probable: un ajuste llamado temperatura regula cuánta audacia se permite. Con temperatura baja, la red elige casi siempre lo esperable; con temperatura alta, se anima a lo raro.
Quinto, todo vuelve a empezar. La palabra elegida se agrega al final del texto y el recorrido completo se repite para buscar la siguiente. Y la siguiente. Una respuesta de varios párrafos es eso: cientos de vueltas por el mismo circuito, una palabra por vez. La inteligencia artificial no piensa la respuesta entera y después la escribe; la va escribiendo a medida que la calcula.
Cómo aprendió
Queda la pregunta de las perillas. ¿Quién las puso en su lugar?
El método es sorprendentemente simple de contar. Se toma una cantidad descomunal de texto escrito por personas, se tapa la palabra siguiente y se le pide a la red que la adivine. Al principio, con las perillas en posiciones al azar, adivina mal. Se mide cuánto se equivocó y se mueve cada perilla un poquito en la dirección que habría reducido el error. Después se repite. Billones de veces.
Lo asombroso es lo que produce esa tarea tan modesta. Para adivinar bien la palabra siguiente en textos de todo tipo, la red termina obligada a captar la gramática, muchos hechos del mundo, estilos de escritura y una buena dosis de razonamiento. Luego viene una etapa de ajuste, con ejemplos de conversación y correcciones, que la convierte en algo que se comporta como un asistente.
Hay un detalle que suele sorprender. Una vez terminado el aprendizaje, las perillas quedan fijas. Cuando alguien conversa con una inteligencia artificial, ella no aprende nada nuevo en sus perillas. Lo que “recuerda” de la conversación es solo el texto que se le vuelve a pasar completo en cada vuelta. La conversación no la cambia; la recorre.
Lo verosímil y lo verdadero
Con todo el recorrido a la vista, puede responderse la pregunta del comienzo: ¿qué es la respuesta sobre el cielo?
No es una observación. Nadie miró por la ventana. Es la continuación más probable de un texto, calculada a partir de cómo suelen continuar textos parecidos. Eso explica tres cosas que se observan a la vez.
Explica por qué la respuesta suena bien. La red fue entrenada, literalmente, para producir lo más verosímil, es decir, lo que más se parece a lo que un humano escribiría en ese contexto. Que suene bien no es un accidente: es su función.
Explica también por qué tantas veces acierta. Los textos con los que aprendió los escribieron personas que describían el mundo, y la verdad tiene una ventaja: es consistente. Los errores son variados y se contradicen entre sí, mientras que los hechos se repiten desde muchas fuentes. Por eso, muy a menudo, lo más probable coincide con lo verdadero.
Y explica, sobre todo, por qué a veces se equivoca con total seguridad.
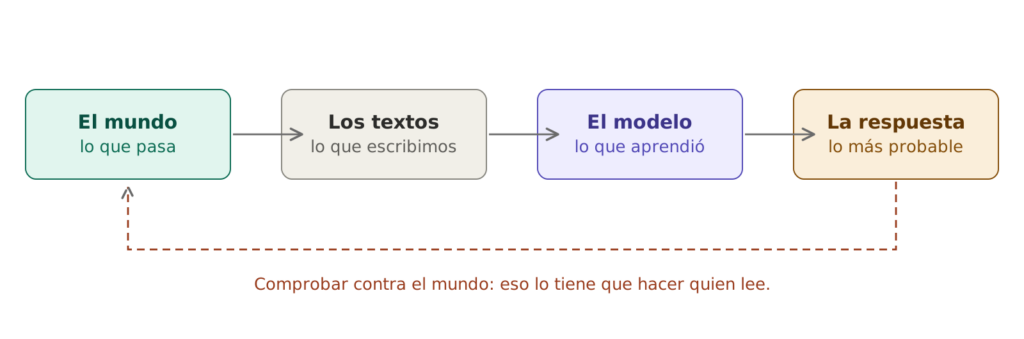
El mapa de un mapa: el mundo produce textos, los textos forman el modelo, el modelo produce respuestas, y comprobarlas contra el mundo queda a cargo de quien leeLa inteligencia artificial es un mapa de un mapa. Nunca tocó el mundo, solo los textos sobre el mundo, y hereda sus huecos, sus sesgos y todo lo que nunca se escribió. No tiene manera de comprobar lo que dice: el mismo mecanismo que produce un dato correcto produce uno inventado, con la misma fluidez y el mismo tono. Cuando inventa, no está fallando; está haciendo exactamente lo que sabe hacer, producir algo verosímil, en un lugar donde lo verosímil y lo verdadero no coincidían. Además, su conocimiento es una foto tomada el día en que terminó de aprender, y cada respuesta es una elección entre candidatos, de modo que la misma pregunta puede dar respuestas distintas.
Lo que queda de nuestro lado
La conclusión no es que haya que desconfiar de la inteligencia artificial, sino entender qué tipo de cosa es lo que entrega. No es un testimonio ni una medición. Se parece más a la opinión de alguien que leyó muchísimo, que casi siempre tiene una idea razonable, pero que no puede salir a la calle a comprobar nada.
Por eso las herramientas que conectan estos sistemas con el exterior, como una búsqueda en la web o un programa que hace cuentas de verdad, cambian tanto su utilidad: le devuelven un punto de apoyo fuera del texto. Y por eso, en el esquema anterior, la última flecha no la dibuja la máquina. La traza quien lee.
Para seguir leyendo
- McCulloch, W. S. y Pitts, W. (1943). “A logical calculus of the ideas immanent in nervous activity”. Bulletin of Mathematical Biophysics, 5, 115–133. https://doi.org/10.1007/BF02478259
- Vaswani, A. y otros (2017). “Attention Is All You Need”. Advances in Neural Information Processing Systems 30. https://arxiv.org/abs/1706.03762
- Bender, E. M. y Koller, A. (2020). “Climbing towards NLU: On Meaning, Form, and Understanding in the Age of Data”. Proceedings of the 58th Annual Meeting of the ACL. https://aclanthology.org/2020.acl-main.463/
- Las referencias completas, con el desarrollo formal de cada paso, están en la tercera parte de esta serie.